VISAPP 2025 / 2025
MEFA
Fusionner avant de détecter.
Le problème
Sous la pluie ou dans le brouillard, un capteur seul ne fournit pas toujours une représentation suffisante de la scène.
L’approche
Un module de fusion précoce par attention combine RGB, infrarouge et LiDAR avant un détecteur d’objets. L’étude compare cette approche à la concaténation des canaux.
Ce que montre l’étude
Le travail étudie la détection de piétons et de véhicules avec YOLOv8 et RT-DETR, dans des conditions météorologiques dégradées. Le module de fusion se place en amont de détecteurs monomodaux.
Résultats qualitatifs publiés — MEFA
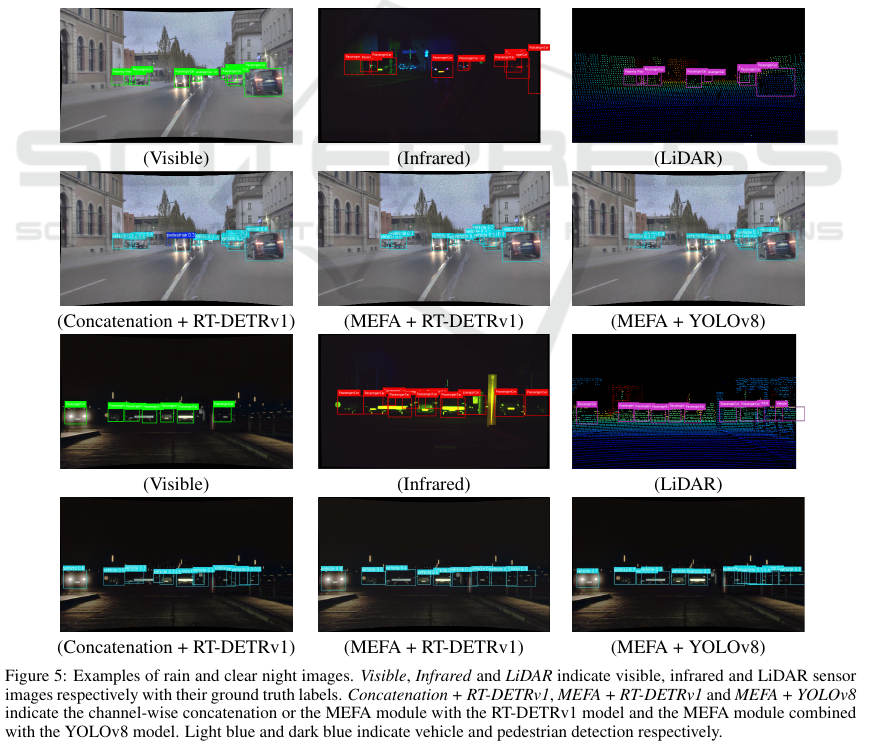
Comparaison par temps de pluie et de nuit : visible, infrarouge, LiDAR, puis détections après concaténation ou MEFA. Figure 5 de l’article original, à lire dans son contexte expérimental.
Dupas, Hotel, Lefebvre & Cérin · VISAPP 2025 · Source : figure 5, p. 616 ↗ · CC BY-NC-ND 4.0 ↗
Publication source : MEFA: Multimodal Image Early Fusion with Attention Module for Pedestrian and Vehicle Detection